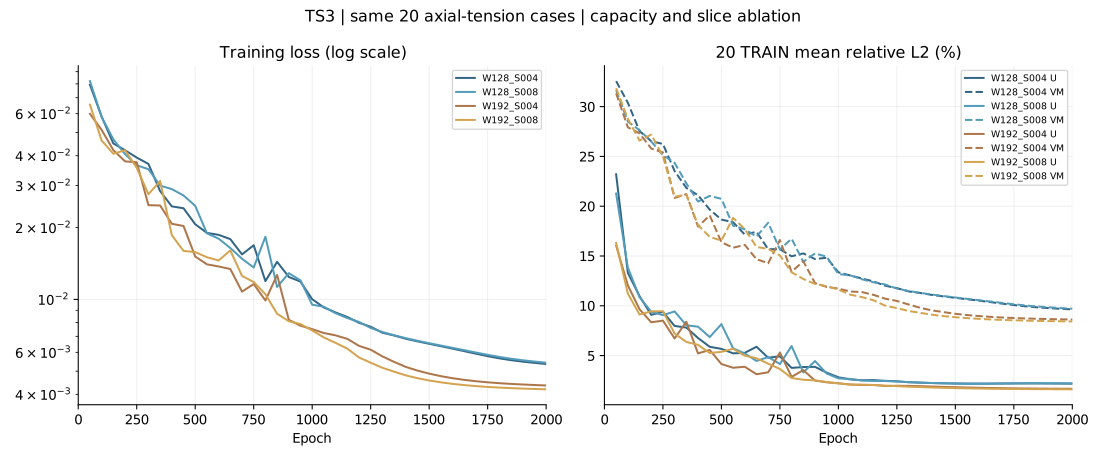
已完成 4/4 组。四组使用相同20个TRAIN几何;每组固定2000轮、全部原TET10节点。当前全量MGN完成且退出后,再独占GPU依次运行。
| 模型 | 层 | 宽 | slots | 参数 | 实际轮数 | 耗时(min) | 最佳checkpoint轮 | U均值/最差 % | 节点VM均值/最差 % |
|---|---|---|---|---|---|---|---|---|---|
| W128_S004 | 8 | 128 | 4 | 982,884 | 2000/2000 | 50.592 | 2000 | 2.178 / 2.841 | 9.636 / 22.618 |
| W128_S008 | 8 | 128 | 8 | 983,428 | 2000/2000 | 56.507 | 2000 | 2.209 / 2.860 | 9.707 / 22.560 |
| W192_S004 | 8 | 192 | 4 | 2,191,588 | 2000/2000 | 69.106 | 2000 | 1.665 / 2.260 | 8.617 / 22.097 |
| W192_S008 | 8 | 192 | 8 | 2,192,388 | 2000/2000 | 52.585 | 2000 | 1.610 / 2.134 | 8.426 / 22.048 |
W128_S004 推理权重 · W128_S008 推理权重 · W192_S004 推理权重 · W192_S008 推理权重 · per_case.csv · curves.csv
用户确认沿用既有标准tension:原大头约束、小头销孔轴向拉伸,无厚度偏载、无惯性;没有重定义两端独立外拉边界,也没有新增有限元求解。种子20261029从120个不同TRAIN拉伸几何中固定选20个,总计1,083,269原节点。不按响应误差挑样,不使用validation/test标签。
固定8层8头,宽128/192与slots4/8构成2×2对照。同宽度共享同形状初始权重,4-slot使用8-slot初始化的前4行;不同宽度按同seed独立初始化。沿用旧OF的AdamW、学习率和全20工况梯度累积更新配方,FP32、TF32允许、无AMP。没有误差门槛或误差早停;训练满2000轮,报告最佳训练checkpoint的实际轮次和误差。
这是同20条纯拉伸TRAIN的容量/slot消融。此前混合载荷20条属于不同数据构成,保留历史结果,不能直接当作本实验同数据大模型基线。loss为等工况平均0.5×(位移向量相对L2平方+投影节点VM相对L2平方),未作曲线平滑。批量模型静态渲染仍需先审核参考图。
完整配置、逐轮数据与核验记录